Indeksacja filtrów w sklepie to decyzja, która w 2026 roku rozstrzyga, czy Google i asystenci zakupowi widzą uporządkowany katalog, czy setki tysięcy niemal identycznych adresów. Reguła jest prosta: kategoria to strona, filtr to parametr, a wyjątek od tej reguły trzeba udowodnić popytem.
W skrócie
- Każdy filtr mnoży liczbę adresów wykładniczo: 5 filtrów po 6 wartości daje ponad 7 700 kombinacji na jedną kategorię.
- Filtr zasługuje na indeks tylko wtedy, gdy ma własny popyt w wyszukiwarce, stabilny asortyment i unikalną treść.
- Do kontroli służą trzy narzędzia:
rel=canonical,noindexi blokada w robots.txt, każde do innego przypadku. - Strona filtra bez własnego opisu, nagłówka i meta jest duplikatem kategorii i tak ją traktuje Google.
- Asystenci AI (ChatGPT, Perplexity) cytują strony filtrów, które opisują konkretną potrzebę, na przykład „kurtki przeciwdeszczowe damskie”.
Dlaczego filtry mnożą adresy w nieskończoność
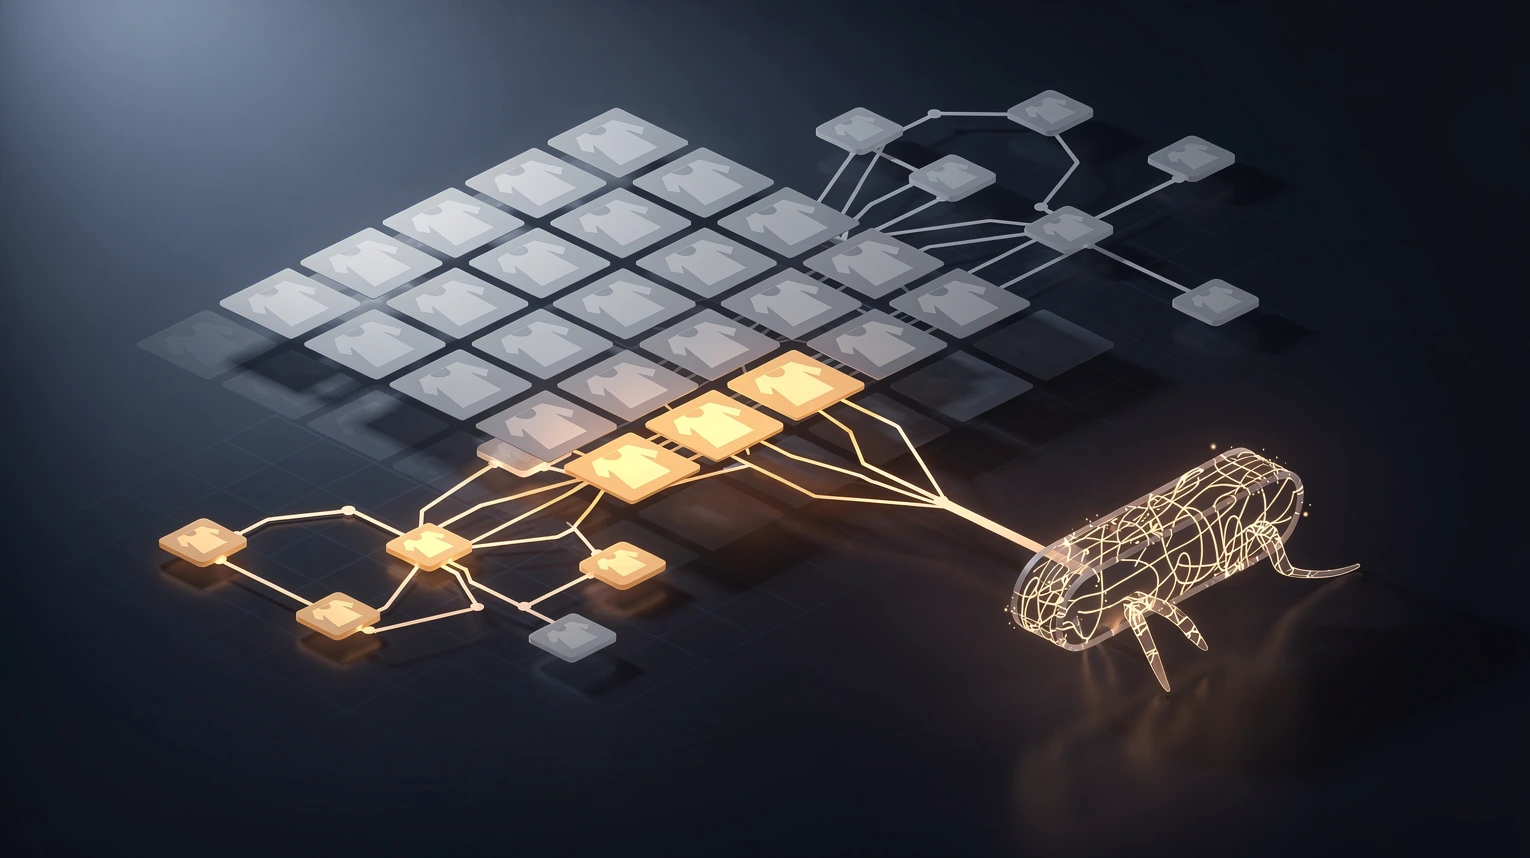
Nawigacja fasetowa generuje adres dla każdej kombinacji wartości, a liczba kombinacji rośnie wykładniczo, nie liniowo. Kategoria „kurtki damskie” z filtrami rozmiaru (6 wartości), koloru (12), marki (20), ceny (5 przedziałów) i materiału (8) daje teoretycznie 6 x 12 x 20 x 5 x 8, czyli 57 600 adresów. Do tego dochodzą sortowania (4 warianty) i paginacja, więc realna liczba przekracza 200 tysięcy.
Większość tych adresów pokazuje ten sam zestaw produktów w innej kolejności albo pusty wynik. Google odkrywa je przez linki w panelu filtrów, a jeśli parametry stoją w losowej kolejności (?kolor=czarny&rozmiar=m i ?rozmiar=m&kolor=czarny), każdy wariant liczy się osobno. Ten mechanizm opisujemy szerzej w tekście o SEO technicznym w 2026 roku, gdzie rendering i kanonikalizacja są dwoma stronami tego samego problemu.
Kryteria: kiedy filtr zasługuje na własną stronę
Filtr zasługuje na indeks, gdy spełnia jednocześnie cztery warunki: popyt, stabilność, unikalność i wielkość asortymentu. Brak dowolnego z nich oznacza, że adres powinien zostać parametrem, a nie stroną. Warunki sprawdzacie w tej kolejności:
- Popyt w wyszukiwarce. Fraza opisująca kombinację (na przykład „buty trekkingowe damskie gore-tex”) ma własne, stałe wolumeny w Planerze słów kluczowych lub w Search Console. Kombinacja „buty trekkingowe rozmiar 38 kolor beżowy” nie ma.
- Stabilny asortyment. Na stronie filtra jest co najmniej 8–10 produktów przez większość roku. Filtr, który po sezonie pokazuje dwa artykuły, generuje stronę niskiej jakości.
- Unikalna treść. Strona ma własny tytuł, nagłówek H1, opis kategorii i meta description. Bez tego jest kopią kategorii nadrzędnej.
- Odrębna intencja. Typ produktu, materiał, przeznaczenie i marka zmieniają intencję zakupową; kolor, rozmiar i cena rzadko.
Praktyczna tabela pomaga w szybkiej klasyfikacji typów filtrów:
| Typ filtra | Indeksować? | Uzasadnienie |
|---|---|---|
| Typ produktu (puchowa, softshell) | Tak | Odrębna intencja, własny popyt, stały asortyment |
| Marka | Tak, wybiórczo | Tylko marki z wolumenem i minimum 10 produktami |
| Materiał lub przeznaczenie | Tak, wybiórczo | Gdy fraza istnieje w wyszukiwarce (gore-tex, wełna, trekking) |
| Kolor | Rzadko | Popyt istnieje dla kilku kategorii (czarna sukienka), reszta to szum |
| Rozmiar | Nie | Brak intencji wyszukiwania, asortyment zmienia się codziennie |
| Cena, sortowanie, paginacja | Nie | Techniczne warianty tego samego zbioru |
| Kombinacje 3+ filtrów | Nie | Popyt zerowy, asortyment niestabilny |
Techniki kontroli: canonical, noindex, robots
Każda z trzech technik rozwiązuje inny problem i nie wolno ich mieszać na tym samym adresie. Google w dokumentacji o nawigacji fasetowej wprost zaleca, by wybrać jedną strategię per typ parametru i stosować ją konsekwentnie.
Canonical: dla kombinacji, które są wariantem strony indeksowanej
Sortowanie, kolejność parametrów i filtry bez popytu (rozmiar, cena) dostają rel=canonical wskazujący na kategorię albo na najbliższy indeksowany filtr. Google konsoliduje sygnały, robot nadal odwiedza stronę, ale nie trafia ona do indeksu. Warunek: treść na stronie wariantowej musi być faktycznie zbliżona do kanonicznej, inaczej Google zignoruje wskazówkę.
Noindex: dla stron, które muszą działać, ale nie mają wartości w wyszukiwarce
Kombinacje trzech i więcej filtrów, puste wyniki i strony wyszukiwania wewnętrznego dostają meta robots noindex, follow. Strona pozostaje dostępna dla użytkownika i przekazuje linki, ale znika z indeksu. Wadą jest to, że robot nadal musi ją pobrać, by zobaczyć dyrektywę, więc noindex nie oszczędza budżetu.
Robots.txt: dla parametrów bez żadnej wartości
Blokada Disallow: /*?sort= albo Disallow: /*&page= zatrzymuje robota przed pobraniem strony i jako jedyna technika realnie chroni budżet crawlowania. Blokujcie wyłącznie parametry, których nigdy nie chcecie w indeksie, bo zablokowany adres nie może przekazać canonical ani noindex. Zasady składni i osobne reguły dla robotów AI omawiamy w poradniku o robots.txt dla botów AI.
Treść na stronie filtra, która ma sens
Strona filtra przeznaczona do indeksu potrzebuje tego samego zestawu elementów co kategoria: własnego H1, tytułu, meta description, krótkiego opisu i linków wewnętrznych. Szablonowe wstawianie nazwy filtra do nagłówka („Kurtki damskie: czarny”) nie wystarcza; nagłówek ma brzmieć jak fraza, którą wpisuje użytkownik („Czarne kurtki damskie”).
Opis powinien mieć 80–150 słów i odpowiadać na pytanie, dlaczego ktoś wybiera akurat ten wariant: kiedy nosić, z czym łączyć, na co zwrócić uwagę w materiale. Umieszczajcie go nad listą produktów albo bezpośrednio pod nią, nie w stopce. Przydatny wzorzec pokazuje case indeksacji 12 tysięcy SKU pod AIO, gdzie każda indeksowana strona filtra dostała trzy zdania opisu i tabelę cech, a pozostałe kombinacje spięto canonicalem.
Dwa elementy techniczne są obowiązkowe. Po pierwsze, indeksowany filtr powinien mieć czysty adres w ścieżce (/kurtki-damskie/puchowe/), nie parametr zapytania. Po drugie, link do niego musi istnieć w stałej nawigacji (menu, opis kategorii, sekcja „popularne wybory”), a nie tylko w dynamicznym panelu filtrów, który często ładuje się przez JavaScript i nie jest widziany przez robota.
Wpływ na budżet crawlowania
Budżet crawlowania jest problemem sklepów powyżej około 10 tysięcy adresów, a nieograniczone filtry potrafią go rozproszyć w kilka tygodni. Google przydziela każdej witrynie limit pobrań wynikający z wydajności serwera i szacowanej wartości stron. Jeśli 90% pobrań trafia w kombinacje filtrów, nowe produkty i zmiany cen czekają na indeksację dniami.
Diagnoza zaczyna się od raportu „Statystyki indeksowania” w Search Console i od logów serwera. W logach szukacie adresów z parametrami, które Googlebot pobiera najczęściej; jeśli na szczycie listy są adresy z sort= lub page=, blokada w robots.txt przynosi natychmiastowy efekt. Po wdrożeniu blokady liczba pobrań wartościowych stron rośnie zwykle w ciągu 2–4 tygodni, co widać jako spadek opóźnienia między publikacją produktu a jego pojawieniem się w indeksie.
Filtry a asystenci zakupowi AI
Asystenci zakupowi w ChatGPT, Perplexity i Gemini cytują strony filtrów chętniej niż ogólne kategorie, pod warunkiem że strona opisuje konkretną potrzebę. Zapytanie użytkownika do asystenta brzmi zwykle jak filtr: „lekka kurtka przeciwdeszczowa damska do biegania do 400 zł”. Strona, której H1 i opis pokrywają tę potrzebę, ma większą szansę na cytowanie niż kategoria „kurtki damskie” z 800 produktami.
Modele językowe nie obsługują panelu filtrów; widzą tylko to, co jest w HTML przy pierwszym pobraniu. Jeśli lista produktów na stronie filtra ładuje się dopiero po interakcji, asystent widzi pustą stronę. Ten sam problem dotyczy mediów i katalogów, o czym piszemy w tekście o SEO dla mediów w 2026 roku: treść, której nie ma w źródle strony, dla LLM nie istnieje.
Wdrożenie na przykładzie sklepu z odzieżą
Sklep z 40 kategoriami, 6 filtrami i 25 tysiącami produktów wdraża zmianę w pięciu krokach, które zajmują zwykle 4–6 tygodni.
- Inwentaryzacja. Eksport wszystkich adresów z parametrami z Search Console i logów z ostatnich 30 dni. W praktyce to 150–400 tysięcy adresów, z czego ponad 95% ma zero wyświetleń.
- Selekcja kandydatów. Dla każdej kategorii lista filtrów typu produktu, marki i materiału z popytem powyżej 50 wyszukiwań miesięcznie i minimum 10 produktami. W sklepie odzieżowym wychodzi zwykle 150–300 stron zamiast setek tysięcy.
- Czyste adresy i treść. Kandydaci dostają adres w ścieżce, własny H1, tytuł, meta description i opis 80–150 słów. Link do każdego z nich trafia do opisu kategorii nadrzędnej lub sekcji „popularne wybory”.
- Reguły kontroli. Sortowanie, widok i paginacja powyżej strony 1 idą do robots.txt; kolor, rozmiar i cena dostają canonical na kategorię lub indeksowany filtr; kombinacje trzech i więcej wartości dostają noindex, follow.
- Monitoring. Po 4 tygodniach sprawdzacie w Search Console liczbę adresów w stanie „Duplikat” (powinna spaść o 60–80%) i w logach udział pobrań stron produktowych (powinien wzrosnąć). Nowe strony filtrów oceniacie po 8–12 tygodniach, bo tyle trwa zbudowanie stabilnych pozycji.
Najczęstszy błąd na tym etapie to wdrożenie canonicali bez zmiany linkowania: robot nadal odkrywa setki tysięcy adresów przez panel filtrów i nadal je pobiera. Drugi to blokada w robots.txt stron, które zdążyły trafić do indeksu; zostają w wynikach bez opisu, dopóki nie dostaną noindex lub przekierowania.
FAQ: najczęstsze pytania o indeksację filtrów
Ile stron filtrów powinien indeksować sklep?
Nie ma stałej liczby, ale praktyczna proporcja to 2–8 indeksowanych filtrów na kategorię. Sklep z 40 kategoriami ma więc 100–300 stron filtrów w indeksie. Każda z nich musi mieć popyt w wyszukiwarce, minimum 8–10 produktów przez większość roku i własny opis. Więcej stron oznacza zwykle więcej duplikatów, nie więcej ruchu.
Czy lepiej użyć canonical czy noindex na stronie filtra?
Canonical stosujecie, gdy strona filtra jest wariantem strony indeksowanej (ten sam asortyment, inna kolejność lub zawężenie bez popytu). Noindex stosujecie, gdy strona nie ma odpowiednika kanonicznego, ale musi działać dla użytkownika, na przykład kombinacja trzech filtrów lub wynik wyszukiwarki wewnętrznej. Nigdy nie łączcie obu dyrektyw na jednym adresie, bo Google dostaje sprzeczne sygnały.
Czy blokada filtrów w robots.txt usuwa je z indeksu?
Nie. Robots.txt zatrzymuje pobieranie, ale adresy, które już były w indeksie, mogą w nim pozostać jako wyniki bez opisu. Jeśli chcecie usunąć zaindeksowane strony filtrów, najpierw dajcie im noindex albo przekierowanie 301, poczekajcie na ponowne pobranie (2–6 tygodni), a dopiero potem dodajcie blokadę w robots.txt.
Czy strona filtra koloru może mieć sens w indeksie?
Tak, w wąskiej grupie kategorii, gdzie kolor jest częścią intencji zakupowej: „czarna sukienka”, „biała koszula”, „beżowy trencz”. Sprawdzacie to w Planerze słów kluczowych: jeśli fraza „kolor + produkt” ma stały wolumen i sklep ma minimum 10 produktów w tym kolorze, strona zasługuje na indeks. Dla większości kategorii (elektronika, narzędzia, kosmetyki) kolor nie zmienia intencji i powinien zostać parametrem z canonicalem.
Co dalej
Po uporządkowaniu filtrów warto sprawdzić, jak sklep renderuje listy produktów dla robotów i asystentów AI, bo najlepiej dobrana strategia indeksacji nie pomoże, jeśli treść ładuje się dopiero po interakcji. Szczegóły techniczne renderingu, hreflang i schemy zbiera przewodnik po SEO technicznym 2026, a mierzalny efekt podobnego wdrożenia opisuje case indeksacji 12 tysięcy SKU.